Por que fizemos isso
Os modelos de anime do EGAKU oferecem há algum tempo estilos como Xilogravura e Nanquim. Mas, na prática, esses estilos só acrescentavam algumas palavras ao seu texto. Ao comparar o mesmo texto com e sem eles, a imagem quase não mudava: continuava uma ilustração anime limpa com um pouco de textura.
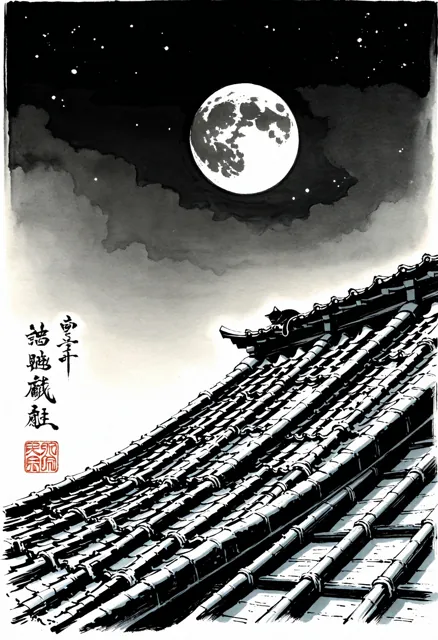
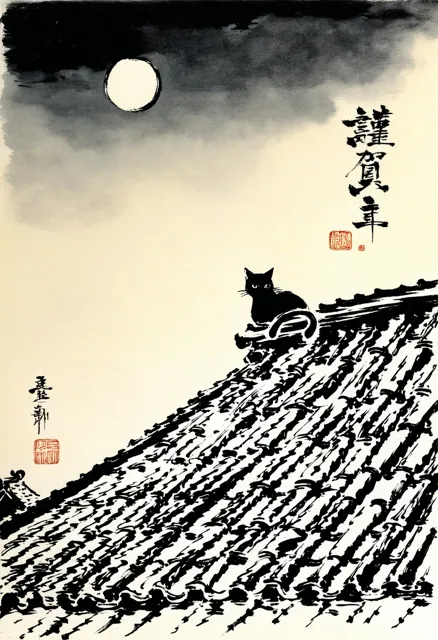
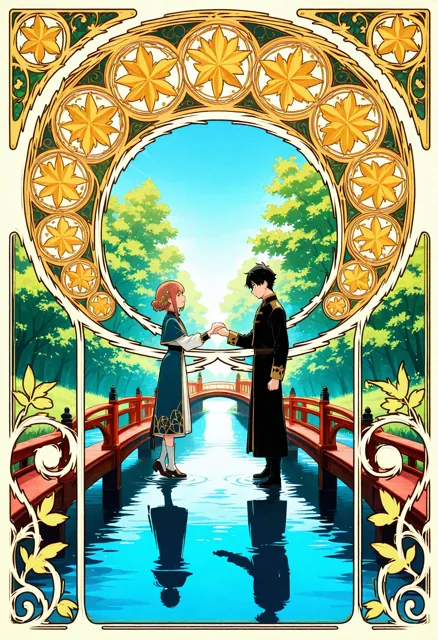
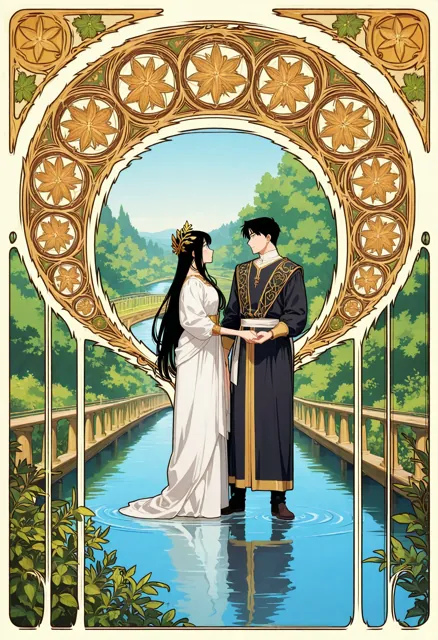
Então treinamos um pequeno modelo de estilo próprio para cada um e o ligamos a quatro estilos: Xilogravura (ukiyo-e), Nanquim, Art Nouveau e um novo estilo Impressionismo.
Treinado só com arte de domínio público
Não usamos imagens coletadas da internet nem nada criado no EGAKU. Cada modelo de estilo aprendeu com cerca de 700 obras em domínio público ou com licença CC0, escolhidas de uma coleção aberta que só contém esse tipo de obra.
- Nenhum artista domina. Limitamos cada artista a 120 obras, para que o estilo ukiyo-e não seja o de um único pintor.
- Sem nomes. Tiramos os nomes dos artistas das descrições de treino, para que o modelo aprenda a aparência e não um nome a imitar.
- Só pessoas adultas. Excluímos toda imagem cuja descrição mencionava uma criança e toda imagem com nudez.
Antes e depois
Mesmo texto, mesma semente; só o modelo de estilo foi acrescentado.
Xilogravura: céus anil, parapeitos vermelhão, estampas de quimono e a cor chapada das gravuras reais.
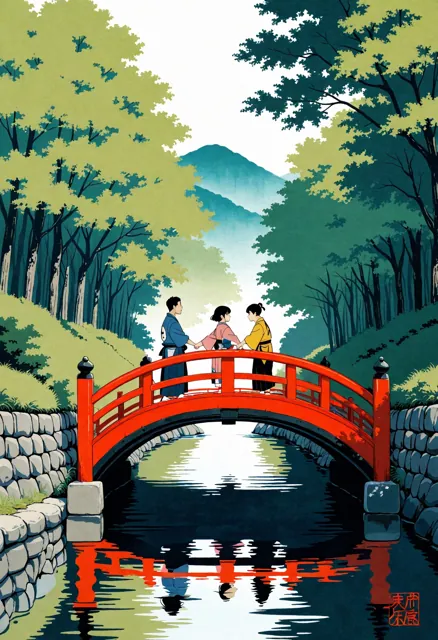
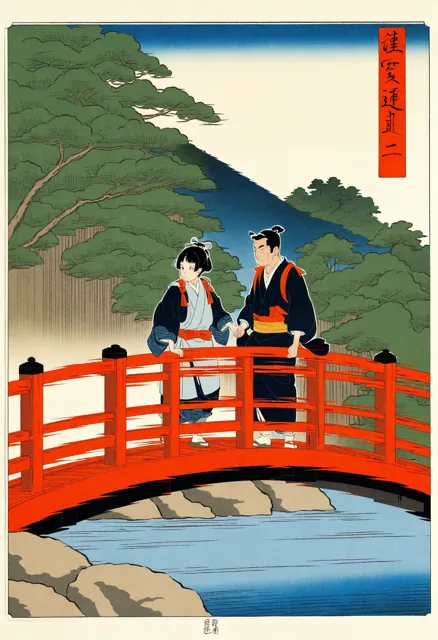
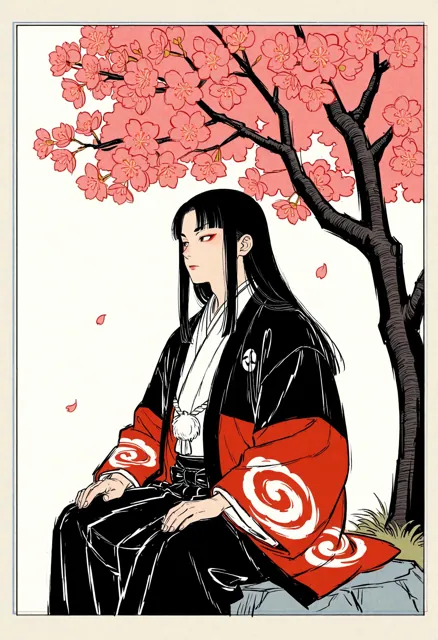
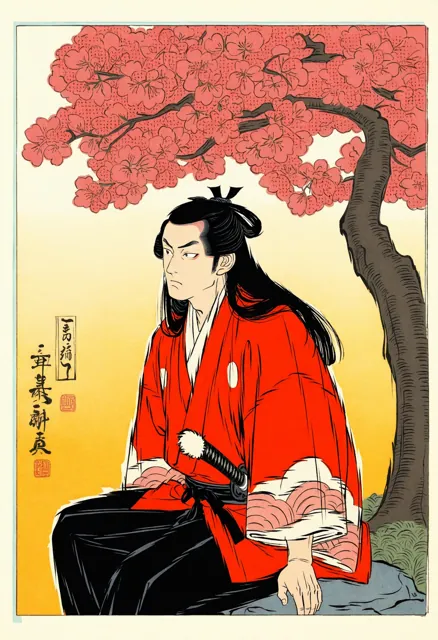
Nanquim: tinta esfumada, espaço vazio e tom de papel em vez de preto e branco puros.
Art Nouveau: o estilo antigo já desenhava uma moldura ornamental; o novo modelo acrescenta a cor e a textura de papel dos cartazes.
Impressionismo (novo): luz salpicada, pinceladas visíveis e contornos suaves.
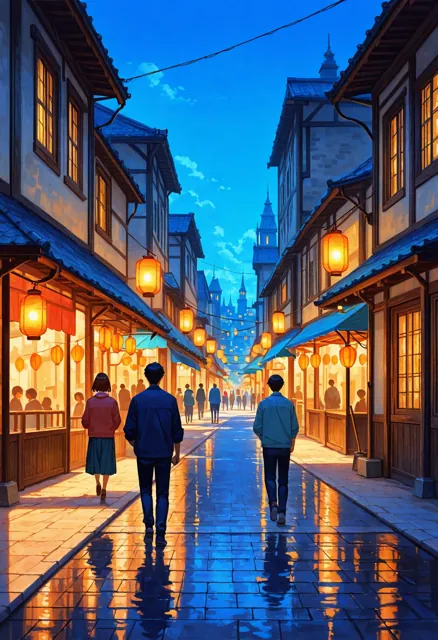
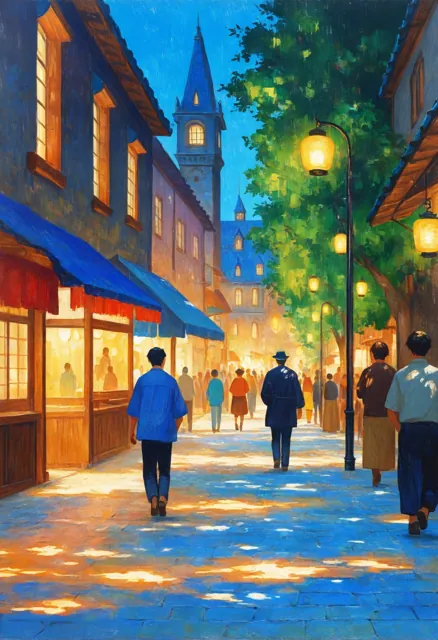
Mais forte não era melhor
Com muita intensidade, o modelo de estilo começa a se impor ao seu texto. No teste de nanquim, duas pessoas numa ponte viraram uma. O modelo ukiyo-e, que viu muitas gravuras de atores de kabuki, transformou uma aventureira no rosto de um ator.
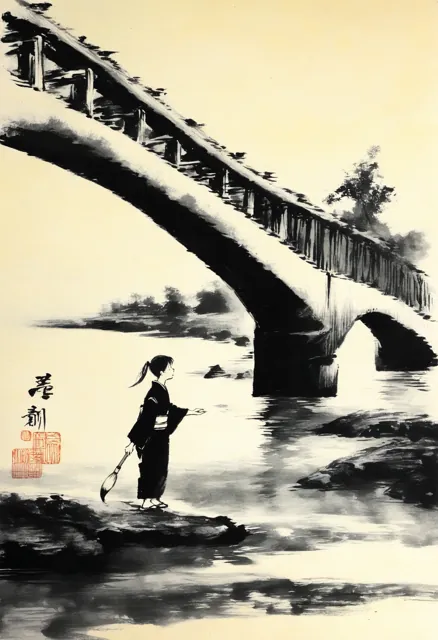
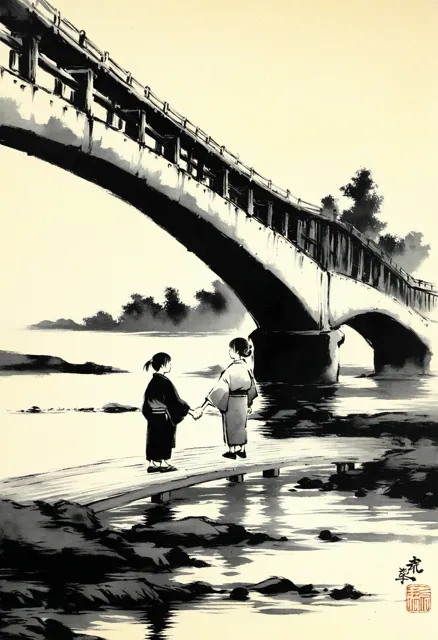
Para cada estilo testamos quatro intensidades com cinco temas diferentes e escolhemos a mais forte que ainda respeitava o pedido: o número certo de pessoas e o tema certo. Resta um limite: no estilo ukiyo-e, um gato tende a virar pessoa, porque quase não há gatos nas gravuras de que ele aprendeu.
Menos braços e pernas a mais
Ao mesmo tempo, lançamos duas mudanças contra a reclamação mais comum das imagens de IA: um braço a mais, uma perna no lugar errado ou dois corpos que se misturam num abraço ou numa dança.
- Escolher a imagem limpa. Quando o texto tem duas pessoas juntas, um abraço ou um movimento grande como um salto ou um chute, nossos modelos de imagem próprios criam um candidato extra. Uma verificação automática procura membros a mais ou fora do lugar, corpos fundidos e o número de pessoas, e você recebe a imagem limpa. Você paga só as imagens que pediu.
- Um acabamento mais limpo no α2. Nosso modelo fotográfico α2 amplia cada imagem e redesenha os detalhes. Mudamos a forma de ampliar antes desse redesenho. No nosso teste com 24 poses difíceis, os casos com problema caíram de 8 para 6, os fragmentos translúcidos ao redor dos corpos sumiram e cada imagem termina cerca de um terço mais rápido.
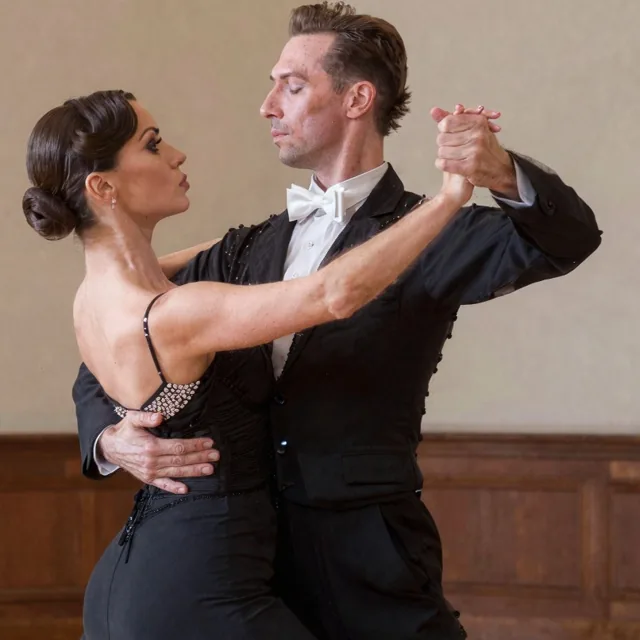
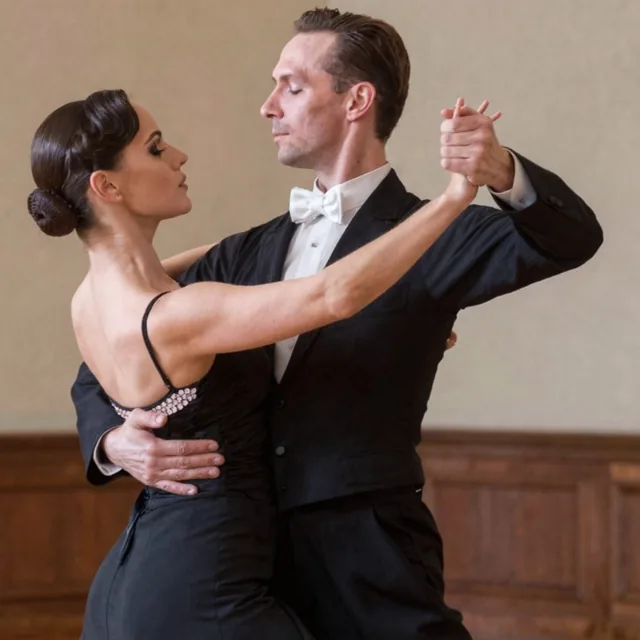
Nada disso torna os erros impossíveis, mas os deixa muito mais raros. Agora estamos trabalhando em definir a pose primeiro em cenas acrobáticas ou com várias pessoas, para que o corpo tenha a forma certa antes de qualquer detalhe.